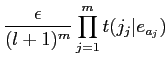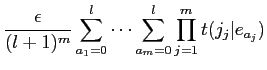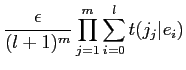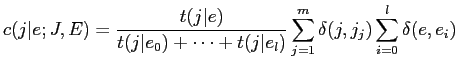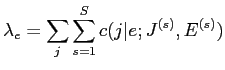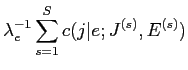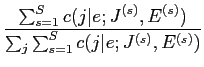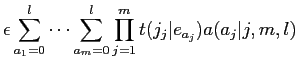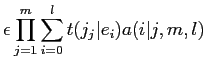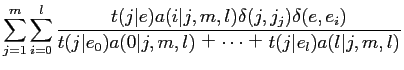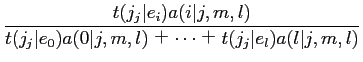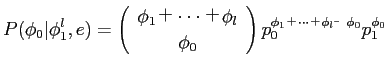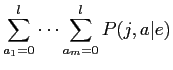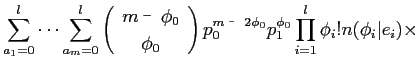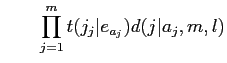next up previous contents
Next: GIZA++ Up: 概要 Previous: 言語モデル   ���罨�

単語に基づく翻訳モデル

統計翻訳における単語対応を獲得するための代表的なモデルとして,IBMのBrownらによる仏英翻訳モデル[2]がある. IBM翻訳モデルは,model1からmodel5までの5つのモデルから構成されている.各モデルの概要を以下に示す.
model1
目的言語のある単語が原言語の単語に訳される確率を用いる
model2
model1に加えて,目的言語のある単語に対応する原言語の単語の原言語文中での位置の確率(以下,permutation確率と呼ぶ)を用いる(絶対位置)
model3
model2に加えて,目的言語のある単語が原言語の何単語に対応するかの確率を用いる
model4
model3のpermutation確率を改良(相対位置)
model5
model4のpermutation確率を更に改良

IBM翻訳モデルは仏英翻訳を前提としているが,本研究では日英翻訳を扱っているため,日英翻訳を前提に説明する.なお,以下の説明は藤原ら[7]の論文より引用した.

原言語の日本語文を$J$,目的言語の英語文を$E$として定義する.IBM翻訳モデルにおいて,日本語文$J$と英語文$E$の翻訳モデル$P(J\vert E)$を計算するため,アライメント\(a\)を用いる.以下にIBMモデルの基本的な計算式を示す.


$\displaystyle P(J\vert E) = \sum_{a}P(J,a\vert E)$     (5)

ここで,アライメント$a$は,$J$と$E$の単語の対応を意味している. IBM翻訳モデルにおいて,各日単語に対応する英単語は1つであるのに対して,各英単語に対応する日単語は0からn個あると仮定する.また,日単語と適切な英単語が対応しない場合,英語文の先頭に$e_{0}$という空単語があると仮定し,日単語と対応させる.

model1

式(3)は以下の式に置き換えられる.
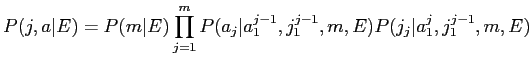
$\displaystyle P(j,a\vert E) = P(m\vert E)\prod_{j=1}^{m}P(a_j\vert a_{1}^{j-1},j_{1}^{j-1},m,E)P(j_{j}\vert a_{1}^{j},j_{1}^{j-1},m,E)$     (6)

$m$は日本語文の文長を示す.また,$a_{1}^{j-1}$は日本語文の1単語目から$j$-1単語目までのアライメントである. そして$j_{1}^{j-1}$は日本語文の1番目から$j$-1番目までの単語を示す. ここで,Model1では以下を仮定している.

以上の仮定を用いて,式(4)は簡略化することができる.以下に式を示す.

$\displaystyle P(J,a\vert E)$ $\textstyle =$ $\displaystyle \frac{\epsilon}{(l+1)^{m}} \prod_{j=1}^{m}t(j_{j}\vert e_{a_{j}})$ (7)
$\displaystyle P(J\vert E)$ $\textstyle =$ $\displaystyle \frac{\epsilon}{(l+1)^{m}} \sum_{a_{1}=0}^{l} \cdots
\sum_{a_{m}=0}^{l} \prod_{j=1}^{m}t(j_{j}\vert e_{a_{j}})$ (8)
  $\textstyle =$ $\displaystyle \frac{\epsilon}{(l+1)^{m}} \prod_{j=1}^{m} \sum_{i=0}^{l}t(j_{j}\vert e_{i})$ (9)

model1において,翻訳確率\(t(j\vert e)\)の初期値が0でない場合, EMアルゴリズムを用いて最適解を推定する.EMアルゴリズムの手順を以下に示す.

手順1
$t(j\vert e)$に初期値を設定する.
手順2
日本語と英語の対訳文($J^{(s)}$,$E^{(s)}$)($1 \leq s$ $\leq S$)において,日単語$j$と英単語$e$が対応付けられる回数の期待値を求める. ここで $\delta(j, j_j)$は日本語文$J$において日単語$j$が出現する回数を表す.そして $\delta(e, e_i)$は英語文$E$において英単語$e$が出現する回数を表す.
$\displaystyle \displaystyle c(j\vert e;J,E) = \frac{t(j\vert e)}{t(j\vert e_0) + \cdots + t(j\vert e_l)} \sum^m_{j=1} \delta(j, j_j) \sum^l_{i=0} \delta(e, e_i)$     (10)

手順3
英語文$E^{(s)}$において,1回以上出現する英単語$e$に対して,翻訳確率$t(j\vert e)$を計算する.

手順4
$t(j\vert e)$が収束するまで,手順2と手順3を繰り返す.

model2

model1において,アライメントの確率は英語文の長さ$l$にのみ依存する. そこでmodel2では,英語文の長さ$l$に加え,$j$単語目のアライメント$a_{j}$, 日本語文の長さ$m$に依存するとし,以下の式で表す.

$\displaystyle a(a_{j}\vert j,m,l) \equiv P(a_{j}\vert a_{1}^{j-1},j_{1}^{j-1},m,l)$     (14)

よって,model1の式(6)は以下のように置き換えられる.
$\displaystyle P(J\vert E)$ $\textstyle =$ $\displaystyle \epsilon \sum_{a_{1}=0}^{l} \cdots \sum_{a_{m}=0}^{l}
\prod_{j=1}^{m}t(j_{j}\vert e_{a_{j}})a(a_{j}\vert j,m,l)$ (15)
  $\textstyle =$ $\displaystyle \epsilon \prod_{j=1}^{m} \sum_{i=0}^{l}t(j_{j}\vert e_{i})a(i\vert j,m,l)$ (16)

model2において,対訳文中の英単語$e$と日単語$j$が対応付けされる回数の期待値である $c(j\vert e;J^{(s)},E^{(s)})$と,日単語の位置$j$と英単語の位置$i$が対応付けられる回数の期待値 $c(i\vert j,m,l;J^{(s)},E^{(s)})$が存在する.以下に,期待値 $c(j\vert e;J^{(s)},E^{(s)})$と $c(i\vert j,m,l;J^{(s)},E^{(s)})$を求める式を示す.

$\displaystyle c(j\vert e;J^{(s)},E^{(s)})$ $\textstyle =$ $\displaystyle \sum_{j=1}^{m} \sum_{i=0}^{l}
\frac{t(j\vert e)a(i\vert j,m,l)\d...
...)}{t(j\vert e_{0})a(0\vert j,m,l)
+ \cdots + t(j\vert e_{l})a(l\vert j,m,l)}$ (17)
$\displaystyle c(i\vert j,m,l;J^{(s)},E^{(s)})$ $\textstyle =$ $\displaystyle \frac{t(j_{j}\vert e_{i})a(i\vert j,m,l)}{t(j_{j}\vert e_{0})a(0\vert j,m,l) + \cdots +
t(j_{j}\vert e_{l})a(l\vert j,m,l)}$ (18)

model2においても,最適解を推定するためにEMアルゴリズムを用いる.しかし,計算によって複数の極大値が算出され,最適解が 得られない場合が存在する.model2の特殊な場合に, $a(i\vert j,m,l)= (l+1)^{-1}$が挙げられるが,これはmodel1として考えることができる.また,最適解が保証されているmodel1で求められた値を初期値として用いることで,最適解を求めることができる.

model3

model1およびmodel2において,日単語と英単語の対応は1対1の場合のみを考慮していた. しかし,model3では,1つの単語が複数の単語に対応する場合や,単語の翻訳位置の距離についても考慮する. また,モデル3では単語の位置を絶対位置として考えている.モデル3では以下のパラメータを用いる.

さらに,英単語に翻訳されない日本語の単語数を$\phi_{0}$として,そのような単語が発生する確率$p_{0}$ を以下の式に表す.
$\displaystyle P(\phi_{0}\vert\phi_{1}^{l},e) =
\left(
\begin{array}{c}
\phi_{1...
...rray}\right)
p_{0}^{\phi_{1} + \cdots + \phi_{l} − \phi_{0}}p_{1}^{\phi_{0}}$     (19)

したがって,model3は以下の式によって表される.


$\displaystyle P(j\vert e)$ $\textstyle =$ $\displaystyle \sum_{a_{1}=0}^{l} \cdots \sum_{a_{m}=0}^{l}P(j,a\vert e)$ (20)
  $\textstyle =$ $\displaystyle \sum_{a_{1}=0}^{l} \cdots \sum_{a_{m}=0}^{l}
\left(
\begin{array...
...\phi_{0}}p_{1}^{\phi_{0}}
\prod_{i=1}^{l}\phi_{i}!n(\phi_{i}\vert e_{i}) \times$  
    $\displaystyle \hspace*{2zw} \prod_{j=1}^{m}t(j_{j}\vert e_{a_{j}})d(j\vert a_{j},m,l)$ (21)

モデル3では,全ての単語対応を考慮して計算するため,計算量が膨大となる.そのため,期待値は近似によって求められる.

model4

model3とmodel4の違いは,単語の位置の考慮の仕方である.model3において,単語の位置は絶対位置で考慮していた.それに対して,model4では単語の位置を相対位置で考慮する.また,各単語ごとの位置も考慮している.model4では,単語位置の歪みの確率である $d(j\vert i,m,l)$を以下の2通りで考慮する.

model5

モデル4では,単語の位置に関して直前の単語のみを考慮している. そのため,複数の単語が同じ位置に生じたり,単語が存在しない位置に生成されるという問題がある. モデル5では,この問題を避けるために,単語を空白部分に配置するように制約が施されている.


next up previous contents
Next: GIZA++ Up: 概要 Previous: 言語モデル   ���罨�
2017-04-20